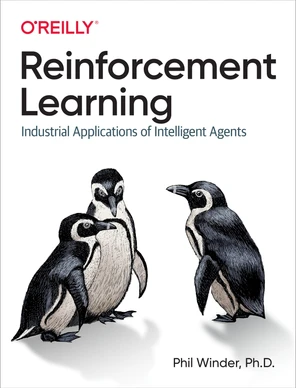
معرفی کتاب یادگیری تقویتی (Reinforcement Learning)
محمدحسین خادم المهدی
10 دقیقه مطالعه
۲۱ مهر ۱۴۰۵
بسیاری از سیستمهای هوش مصنوعی برای پیشبینی، طبقهبندی یا تولید خروجی بر اساس دادههای موجود آموزش میبینند. اما چه میشود اگر هدف، تنها پیشبینی یک پاسخ نباشد و سیستم لازم باشد در طول زمان تصمیم بگیرد، نتیجه اقدامات خود را مشاهده کند و با تجربهکردن، تصمیمهای بهتری بگیرد؟
برای مثال، یک ربات باید یاد بگیرد چگونه حرکت کند، یک سیستم مدیریت انرژی باید مصرف را با توجه به شرایط تغییر دهد و یک عامل هوشمند باید بتواند میان گزینههای مختلف انتخاب کند تا در بلندمدت به نتیجه بهتری برسد.
این دسته از مسائل یکی از موضوعات اصلی یادگیری تقویتی (Reinforcement Learning) هستند؛ شاخهای از یادگیری ماشین که در آن یک عامل با تعامل با محیط و دریافت پاداش یا بازخورد، یاد میگیرد چگونه تصمیم بگیرد.
کتاب Reinforcement Learning: Industrial Applications with Intelligent Agents نوشته فیل ویندر (Phil Winder)، به بررسی مبانی، الگوریتمها و کاربردهای عملی این حوزه میپردازد. این کتاب از مفاهیم اولیه شروع میکند و تا روشهای پیشرفته یادگیری تقویتی، کاربردهای صنعتی و ملاحظات پیادهسازی در محیط عملیاتی پیش میرود.
تمرکز این کتاب بر یادگیری تقویتی و استفاده از آن برای حل مسائل تصمیمگیری است. در این رویکرد، عامل هوشمند در یک محیط قرار میگیرد، وضعیت محیط را مشاهده میکند، اقدامی انجام میدهد و بر اساس نتیجه آن، بازخورد دریافت میکند.
هدف عامل این است که با یادگیری از تجربه، سیاستی برای انتخاب اقدامات پیدا کند که مجموع پاداشهای مورد انتظار را در طول زمان افزایش دهد.
این فرایند در ظاهر ساده به نظر میرسد، اما طراحی یک الگوریتم مؤثر به عوامل مختلفی بستگی دارد؛ از جمله نحوه تعریف وضعیتها و اقدامات، طراحی تابع پاداش، شیوه اکتشاف گزینههای جدید و روش ارزیابی عملکرد.
کتاب با معرفی این مفاهیم، به خواننده کمک میکند منطق پشت الگوریتمهای یادگیری تقویتی را درک کند و با روشهای مختلف حل مسائل آشنا شود.
همچنین، بخش مهمی از کتاب به کاربردهای صنعتی اختصاص دارد؛ از بهینهسازی مصرف انرژی و تبلیغات آنلاین گرفته تا سیستمهای پیشنهاددهنده، کنترل و تصمیمگیری خودکار.
در بسیاری از مسائل واقعی، بهترین تصمیم به شرایط فعلی محدود نمیشود. ممکن است اقدامی در کوتاهمدت سودمند باشد، اما در بلندمدت نتیجه نامطلوبی ایجاد کند.
برای مثال، فرض کنید یک سیستم باید هزینه اجرای یک زیرساخت نرمافزاری را کاهش دهد. کاهش منابع در لحظه ممکن است هزینه را کم کند، اما اگر بار کاری افزایش پیدا کند، عملکرد سیستم افت خواهد کرد.
یک مسئله یادگیری تقویتی میتواند بهگونهای تعریف شود که عامل، وضعیت سیستم را مشاهده کند، اقدام مناسبی انتخاب کند و با توجه به پیامدهای آن، سیاست تصمیمگیری خود را بهبود دهد.
البته استفاده از یادگیری تقویتی همیشه ضروری یا بهینه نیست. این روش زمانی ارزشمندتر است که مسئله واقعاً شامل تصمیمگیری متوالی، پیامدهای بلندمدت و امکان دریافت بازخورد مناسب باشد.
شناخت همین شرایط، یکی از مهارتهایی است که مطالعه اصول یادگیری تقویتی در اختیار شما قرار میدهد.
برای فهم یادگیری تقویتی باید ابتدا اجزای اصلی آن را بشناسید.
عامل (Agent) تصمیمگیرنده است، محیط (Environment) فضایی است که عامل در آن فعالیت میکند، اقدام (Action) انتخابی است که عامل انجام میدهد و پاداش (Reward) بازخوردی است که برای ارزیابی پیامد اقدامات دریافت میشود.
عامل با استفاده از اطلاعات وضعیت فعلی و تجربههای قبلی، تلاش میکند سیاستی برای انتخاب اقدامات مناسب پیدا کند.
این چارچوب به شما کمک میکند مسائل پیچیده را به اجزای مشخص تقسیم کنید و بررسی کنید که آیا یک مسئله واقعاً برای حل با یادگیری تقویتی مناسب است یا خیر.
فرآیند تصمیمگیری مارکوف (Markov Decision Process یا MDP) یکی از چارچوبهای بنیادی برای مدلسازی مسائل یادگیری تقویتی است.
در این چارچوب، وضعیتها، اقدامات، احتمال انتقال میان وضعیتها و پاداشها مشخص میشوند. سپس میتوان مسئله تصمیمگیری را به شکلی رسمیتر تحلیل کرد.
تابع ارزش نیز به ما کمک میکند کیفیت یک وضعیت یا اقدام را با توجه به پاداشهای مورد انتظار آینده بسنجیم.
با درک این مفاهیم، میتوانید بفهمید الگوریتمهای یادگیری تقویتی چگونه درباره کیفیت تصمیمها تخمین میزنند و چگونه این تخمینها به انتخاب اقدامات بهتر منجر میشوند.
برنامهنویسی پویا (Dynamic Programming) از ساختار مسئله و اطلاعات مربوط به محیط برای محاسبه یا بهبود سیاست تصمیمگیری استفاده میکند.
روشهای مونتکارلو (Monte Carlo Methods) نیز از نمونههای تجربه و بازگشت پاداش حاصل از اجرای مسیرهای مختلف برای تخمین ارزش وضعیتها و سیاستها بهره میگیرند.
شناخت تفاوت این روشها به شما کمک میکند بفهمید الگوریتمها برای یادگیری به چه نوع اطلاعاتی نیاز دارند و در چه شرایطی قابل استفاده هستند.
یادگیری اختلاف زمانی (Temporal-Difference Learning) یکی از روشهای مهم یادگیری از تجربه است که در آن تخمینهای فعلی با استفاده از بازخوردهای جدید بهروزرسانی میشوند.
یکی از الگوریتمهای شناختهشده این خانواده، Q-Learning است. این الگوریتم تلاش میکند ارزش انجام یک اقدام در یک وضعیت مشخص را یاد بگیرد تا عامل بتواند در آینده اقدامات مناسبتری انتخاب کند.
همچنین، با الگوریتمهایی مانند SARSA، Double Q-Learning و روشهای چندمرحلهای آشنا میشوید که هرکدام راهکار متفاوتی برای یادگیری ارزش اقدامات و بهبود عملکرد ارائه میدهند.
این مباحث پایه مهمی برای درک روشهای پیشرفتهتر یادگیری تقویتی هستند.
وقتی تعداد وضعیتها یا اقدامات بسیار زیاد باشد، نگهداری یک جدول ساده برای ثبت ارزش هر وضعیت یا اقدام دیگر عملی نیست.
در چنین شرایطی میتوان از شبکههای عصبی برای تقریب توابع ارزش یا سیاست تصمیمگیری استفاده کرد. ترکیب یادگیری تقویتی با یادگیری عمیق، زمینه شکلگیری یادگیری تقویتی عمیق (Deep Reinforcement Learning) را فراهم میکند.
کتاب به روشهایی مانند Deep Q-Network یا DQN و بهبودهای آن، از جمله Rainbow DQN، میپردازد.
با مطالعه این بخش، بهتر درک میکنید که شبکههای عصبی چگونه میتوانند در مسائل تصمیمگیری پیچیده نقش داشته باشند و چه چالشهایی در آموزش و ارزیابی چنین سیستمهایی وجود دارد.
همه الگوریتمهای یادگیری تقویتی به یک شکل عمل نمیکنند. بعضی روشها بر تخمین ارزش وضعیتها و اقدامات تکیه دارند، درحالیکه روشهای Policy Gradient مستقیماً سیاست تصمیمگیری را بهینه میکنند.
در این مسیر، با الگوریتمهایی مانند REINFORCE، Actor-Critic، PPO، TD3 و SAC آشنا میشوید.
هر الگوریتم برای شرایط خاصی طراحی شده و ویژگیها، مزایا و محدودیتهای خود را دارد. بنابراین، انتخاب الگوریتم مناسب به نوع مسئله، فضای اقدامات، پایداری آموزش، هزینه محاسباتی و معیارهای ارزیابی بستگی دارد.
هدف از یادگیری این روشها صرفاً حفظ نام الگوریتمها نیست؛ بلکه باید بتوانید منطق عملکرد آنها و تفاوت رویکردهای مختلف را درک کنید.
یکی از چالشهای مهم در یادگیری تقویتی، تعریف تابع پاداش است. عامل بر اساس پاداشی که دریافت میکند یاد میگیرد؛ بنابراین، اگر تابع پاداش بهدرستی طراحی نشده باشد، ممکن است رفتاری ایجاد شود که از نظر عددی مطلوب به نظر برسد، اما با هدف واقعی مسئله مطابقت نداشته باشد.
برای مثال، اگر هدف یک سیستم صرفاً کاهش زمان انجام یک وظیفه باشد، ممکن است عامل کیفیت یا ایمنی را نادیده بگیرد؛ مگر اینکه این محدودیتها در طراحی مسئله لحاظ شده باشند.
درک طراحی پاداش، انتخاب وضعیتهای مناسب و تعریف فضای اقدامات به شما کمک میکند مسئله را دقیقتر صورتبندی کنید و نتایج آموزش را واقعبینانهتر ارزیابی کنید.
ساخت یک الگوریتم که در محیط آزمایشی عملکرد خوبی دارد، با استفاده از آن در یک سیستم واقعی تفاوت دارد.
در محیط عملیاتی، باید به مسائلی مانند مقیاسپذیری، پایش عملکرد، ارزیابی سیاست، ایمنی، هزینه اجرا و مدیریت خطا توجه کرد.
کتاب بخشهایی را به چرخه عمر پروژههای یادگیری تقویتی، طراحی محیط، ارزیابی، استقرار و نگهداری اختصاص میدهد.
این مباحث به شما کمک میکنند بفهمید توسعه یک سیستم یادگیری تقویتی فقط به انتخاب الگوریتم و آموزش آن محدود نیست؛ بلکه به طراحی و مدیریت کل فرایند نیاز دارد.
مهمترین نتیجه مطالعه این کتاب، شکلگیری درکی منسجمتر از نحوه یادگیری و تصمیمگیری عاملهای هوشمند است.
در ابتدای مسیر، ممکن است یادگیری تقویتی را صرفاً روشی بدانید که در آن مدل با دریافت پاداش آموزش میبیند. اما پس از مطالعه مباحث کتاب، بهتر میتوانید اجزای مسئله را تحلیل کنید، روشهای مختلف را از یکدیگر تشخیص دهید و درباره انتخاب الگوریتم تصمیم بگیرید.
برای مثال، میتوانید پرسشهای دقیقتری مطرح کنید:
آیا مسئله من واقعاً به یادگیری تقویتی نیاز دارد یا روش سادهتری کافی است؟
چگونه باید وضعیتها، اقدامات و تابع پاداش را تعریف کنم؟
چه تفاوتی میان Q-Learning و روشهای Policy Gradient وجود دارد؟
چه زمانی استفاده از شبکه عصبی در یادگیری تقویتی ضروری میشود؟
چگونه میتوان عملکرد عامل را در یک محیط آزمایشی ارزیابی کرد؟
چه ملاحظاتی برای انتقال یک سیاست یادگرفتهشده به محیط عملیاتی وجود دارد؟
این دانش میتواند پایه مناسبی برای ساخت پروژههای آزمایشی و مطالعه عمیقتر الگوریتمهای یادگیری تقویتی باشد.
البته این کتاب را نباید جایگزین تجربه عملی دانست. برای تسلط بر الگوریتمها، لازم است آنها را پیادهسازی کنید، آزمایشها را تکرار کنید، نتایج را مقایسه کنید و با مشکلاتی مانند ناپایداری آموزش، طراحی نامناسب پاداش و تعمیمپذیری مواجه شوید.
همچنین، آشنایی با مفاهیم پایه یادگیری ماشین، احتمال و ریاضیات میتواند درک مباحث پیشرفتهتر را آسانتر کند.
متخصصان یادگیری ماشین: اگر میخواهید فراتر از مسائل پیشبینی و طبقهبندی بروید و روشهای تصمیمگیری متوالی را یاد بگیرید، این کتاب میتواند دانش شما را گسترش دهد.
دانشمندان داده: اگر به مسائل بهینهسازی، تصمیمگیری خودکار و یادگیری از تعامل علاقه دارید، مباحث کتاب میتوانند دید مناسبی درباره کاربردهای یادگیری تقویتی در مسائل صنعتی ارائه دهند.
مهندسان هوش مصنوعی: اگر قصد دارید عاملهای هوشمند بسازید یا الگوریتمهای یادگیری تقویتی را در پروژههای واقعی بررسی کنید، این کتاب به شناخت روشها و ملاحظات مهندسی آنها کمک میکند.
پژوهشگران و دانشجویان هوش مصنوعی: اگر میخواهید پایه نظری و الگوریتمی یادگیری تقویتی را تقویت کنید، این کتاب میتواند نقطه شروعی برای مطالعه روشهای کلاسیک و پیشرفته باشد.
با این حال، کتاب برای کسانی که هیچ پیشزمینهای در یادگیری ماشین ندارند ممکن است چالشبرانگیز باشد. آشنایی مقدماتی با Python، احتمال، مفاهیم یادگیری ماشین و ریاضیات پایه میتواند مسیر یادگیری را هموارتر کند.
یادگیری تقویتی حوزهای است که مطالعه نظری آن بدون آزمایش عملی میتواند دشوار باشد. بهترین راه برای درک بسیاری از الگوریتمها، مشاهده رفتار آنها در یک محیط ساده و بررسی نتایج آموزش است.
برای شروع، میتوانید یک مسئله کوچک مانند محیط GridWorld یا کنترل یک عامل در محیط CartPole را انتخاب کنید. سپس یک الگوریتم پایه مانند Q-Learning یا DQN را پیادهسازی کنید و تغییرات عملکرد عامل را با تنظیم پارامترهای مختلف بررسی کنید.
همچنین میتوانید تأثیر طراحی تابع پاداش، میزان اکتشاف و تعداد مراحل آموزش را مقایسه کنید. این آزمایشها کمک میکنند ارتباط میان مفاهیم نظری و رفتار واقعی الگوریتم را بهتر بفهمید.
در کنار تمرین، مرور مفاهیم کلیدی با فلشکارت میتواند به تثبیت اصطلاحات و تفاوت الگوریتمها کمک کند.
در CardDev، محتوای این کتاب با فلشکارتها، گالریکارتها، فایلهای صوتی و واژهنامه ارائه شده است تا مرور مفاهیم و پیگیری مسیر مطالعه آسانتر شود.
کتاب Reinforcement Learning نوشته فیل ویندر، راهنمایی برای آشنایی با مبانی، الگوریتمها و کاربردهای صنعتی یادگیری تقویتی است.
این کتاب به شما کمک میکند بفهمید عاملهای هوشمند چگونه از تعامل با محیط یاد میگیرند، چطور ارزش اقدامات را تخمین میزنند، چگونه سیاستهای تصمیمگیری را بهبود میدهند و چه چالشهایی در استفاده از این روشها در مسائل واقعی وجود دارد.
اگر در حوزه یادگیری ماشین، علم داده یا هوش مصنوعی فعالیت میکنید و میخواهید درک عمیقتری از یادگیری مبتنی بر تجربه و تصمیمگیری متوالی به دست آورید، این کتاب میتواند منبعی ارزشمند برای یادگیری و تمرین باشد.
هدف نهایی یادگیری تقویتی، فقط آموزش یک مدل نیست؛ بلکه ساخت عاملی است که بتواند با تجربهکردن، دریافت بازخورد و ارزیابی پیامد اقدامات، تصمیمهای بهتری برای رسیدن به اهداف خود بگیرد.