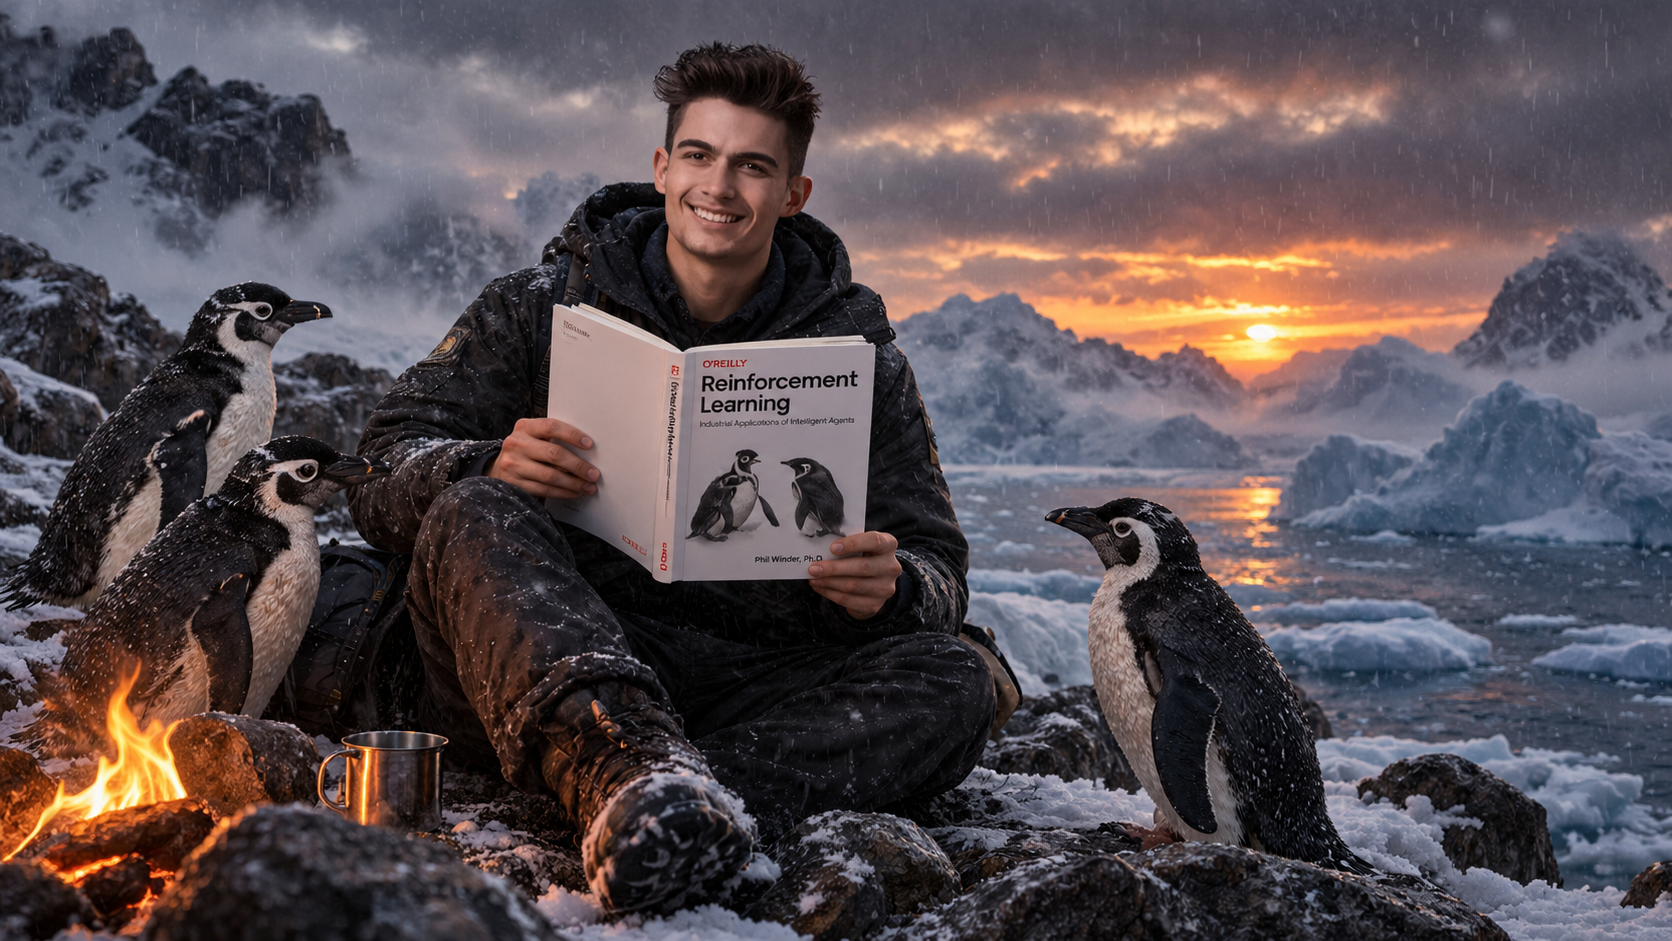
یادگیری تقویتی (Reinforcement Learning) یکی از بزرگترین پیشرفتها در حوزه هوش مصنوعی (Artificial Intelligence) را طی دهه آینده رقم خواهد زد و به الگوریتمها امکان میدهد تا از محیط خود برای دستیابی به اهداف دلخواه بیاموزند. این توسعه هیجانانگیز محدودیتهای موجود در الگوریتمهای سنتی یادگیری ماشین (Machine Learning) را برطرف میکند. این کتاب کاربردی به متخصصان علم داده (Data Science) و هوش مصنوعی نشان میدهد که چگونه با استفاده از یادگیری تقویتی، به ماشین بیاموزند که خودش یاد بگیرد. نویسنده، فیل ویندر (Phil Winder) از شرکت ویندر ریسرچ (Winder Research)، همهچیز را از بلوکهای سازنده پایه تا پیشرفتهترین روشها پوشش میدهد. شما وضعیت فعلی یادگیری تقویتی را بررسی خواهید کرد، بر کاربردهای صنعتی تمرکز میکنید، الگوریتمهای متعددی را میآموزید و از فصلهای اختصاصی درباره دیپلوی (Deploy) کردن راهکارهای یادگیری تقویتی در محیط پروداکشن (Production) بهرهمند میشوید. این کتاب یک کتاب آشپزی (Cookbook) ساده نیست؛ از ریاضیات دوری نمیکند و انتظار آشنایی با یادگیری ماشین را دارد. بیاموزید که یادگیری تقویتی چیست و چگونه الگوریتمها به حل مسائل کمک میکنند. در اصول بنیادین یادگیری تقویتی شامل فرآیندهای تصمیمگیری مارکوف (Markov Decision Processes)، برنامهنویسی پویا (Dynamic Programming) و یادگیری اختلاف زمانی (Temporal Difference Learning) غوطهور شوید. به بررسی عمیق طیف وسیعی از روشهای ارزش و گرادیان خطمشی (Policy Gradient Methods) بپردازید. راهکارهای پیشرفته یادگیری تقویتی مانند فرا-یادگیری (Meta Learning)، یادگیری سلسلهمراتبی (Hierarchical Learning)، یادگیری چند عاملی (Multi-Agent) و یادگیری تقلیدی (Imitation Learning) را به کار ببرید. الگوریتمهای پیشرفته یادگیری تقویتی عمیق (Deep RL) شامل رینبو (Rainbow)، پیپیاو (PPO)، تیدیتری (TD3)، ساک (SAC) و موارد دیگر را درک کنید. از طریق وبسایت همراه کتاب، نمونههای کاربردی دریافت کنید.
اشتراکی
مروری بر ساختار و اطلاعات کلیدی کتاب
۱۶ آبان ۱۳۹۹
1 کتاب
11 فصل
408 صفحه
متوسط تا پیشرفته
یادگیری تقویتی (Reinforcement Learning) یکی از بزرگترین پیشرفتها در حوزه هوش مصنوعی (Artificial Intelligence) را طی دهه آینده رقم خواهد زد و به الگوریتمها امکان میدهد تا از محیط خود برای دستیابی به اهداف دلخواه بیاموزند.
این توسعه هیجانانگیز محدودیتهای موجود در الگوریتمهای سنتی یادگیری ماشین (Machine Learning) را برطرف میکند.
این کتاب کاربردی به متخصصان علم داده (Data Science) و هوش مصنوعی نشان میدهد که چگونه با استفاده از یادگیری تقویتی، به ماشین بیاموزند که خودش یاد بگیرد.
نویسنده، فیل ویندر (Phil Winder) از شرکت ویندر ریسرچ (Winder Research)، همهچیز را از بلوکهای سازنده پایه تا پیشرفتهترین روشها پوشش میدهد.
شما وضعیت فعلی یادگیری تقویتی را بررسی خواهید کرد، بر کاربردهای صنعتی تمرکز میکنید، الگوریتمهای متعددی را میآموزید و از فصلهای اختصاصی درباره دیپلوی (Deploy) کردن راهکارهای یادگیری تقویتی در محیط پروداکشن (Production) بهرهمند میشوید.
این کتاب یک کتاب آشپزی (Cookbook) ساده نیست؛ از ریاضیات دوری نمیکند و انتظار آشنایی با یادگیری ماشین را دارد.
بیاموزید که یادگیری تقویتی چیست و چگونه الگوریتمها به حل مسائل کمک میکنند.
در اصول بنیادین یادگیری تقویتی شامل فرآیندهای تصمیمگیری مارکوف (Markov Decision Processes)، برنامهنویسی پویا (Dynamic Programming) و یادگیری اختلاف زمانی (Temporal Difference Learning) غوطهور شوید.
به بررسی عمیق طیف وسیعی از روشهای ارزش و گرادیان خطمشی (Policy Gradient Methods) بپردازید.
راهکارهای پیشرفته یادگیری تقویتی مانند فرا-یادگیری (Meta Learning)، یادگیری سلسلهمراتبی (Hierarchical Learning)، یادگیری چند عاملی (Multi-Agent) و یادگیری تقلیدی (Imitation Learning) را به کار ببرید.
الگوریتمهای پیشرفته یادگیری تقویتی عمیق (Deep RL) شامل رینبو (Rainbow)، پیپیاو (PPO)، تیدیتری (TD3)، ساک (SAC) و موارد دیگر را درک کنید.
از طریق وبسایت همراه کتاب، نمونههای کاربردی دریافت کنید.
با مرور این بخش، درک سریع و کلی از محتوای کتاب پیدا کنید.
این بخش به بررسی مفاهیم پایه و اساسی در یادگیری تقویتی اختصاص دارد. شما با فرآیندهای تصمیمگیری مارکوف و برنامهنویسی پویا آشنا میشوید. همچنین روشهای یادگیری اختلاف زمانی و تفاوتهای میان آنها به دقت بررسی میشود. این مبانی برای درک عمیقتر الگوریتمهای پیشرفتهتر ضروری هستند.
این بخش به الگوریتمهای پیشرفته از جمله شبکههای کیوتی عمیق (Deep Q-Networks) و روشهای گرادیان خطمشی میپردازد. شما یاد میگیرید چگونه از معماریهای یادگیری عمیق (Deep Learning) در حل مسائل پیچیده استفاده کنید. روشهایی مانند رینبو و ساک برای بهبود عملکرد ارزیابی میشوند. این مطالب مهارتهای لازم برای پیادهسازی پروژههای واقعی را فراهم میکنند.
نویسندگانی که در پشت محتوای این کتاب قرار دارند، از برجستهترین متخصصان و پیشگامان حوزه خود به شمار میروند. آثار آنها حاصل سالها تجربه عملی، پژوهش عمیق و همکاری با بزرگترین سازمانها و شرکتهای فناوری جهان است. هر یک از این نویسندگان با انتشار کتابها و مقالات تخصصی، نقش مهمی در شکلگیری و پیشرفت دانش فنی جامعه جهانی ایفا کردهاند.
تجربه کاربران از این کتاب - نظرات خریداران و دیگر کاربران
منتشر شده
مدت زمان خوانش
11:49
نوع کتاب
اشتراکی
شرکت کنندگان
0 نفر
تولید کتاب
۱۶ مهر ۱۴۰۵