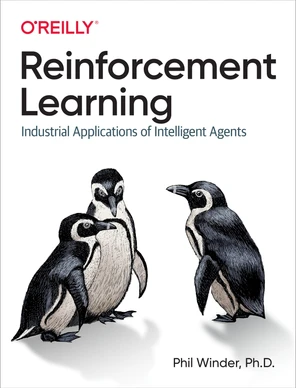
یادگیری تقویتی (Reinforcement Learning) یکی از بزرگترین پیشرفتها در حوزه هوش مصنوعی (Artificial Intelligence) را طی دهه آینده رقم خواهد زد و به الگوریتمها امکان میدهد تا از محیط خود برای دستیابی به اهداف دلخواه بیاموزند. این توسعه هیجانانگیز محدودیتهای موجود در الگوریتمهای سنتی یادگیری ماشین (Machine Learning) را برطرف میکند. این کتاب کاربردی به متخصصان علم داده (Data Science) و هوش مصنوعی نشان میدهد که چگونه با استفاده از یادگیری تقویتی، به ماشین بیاموزند که خودش یاد بگیرد. نویسنده، فیل ویندر (Phil Winder) از شرکت ویندر ریسرچ (Winder Research)، همهچیز را از بلوکهای سازنده پایه تا پیشرفتهترین روشها پوشش میدهد. شما وضعیت فعلی یادگیری تقویتی را بررسی خواهید کرد، بر کاربردهای صنعتی تمرکز میکنید، الگوریتمهای متعددی را میآموزید و از فصلهای اختصاصی درباره دیپلوی (Deploy) کردن راهکارهای یادگیری تقویتی در محیط پروداکشن (Production) بهرهمند میشوید. این کتاب یک کتاب آشپزی (Cookbook) ساده نیست؛ از ریاضیات دوری نمیکند و انتظار آشنایی با یادگیری ماشین را دارد. بیاموزید که یادگیری تقویتی چیست و چگونه الگوریتمها به حل مسائل کمک میکنند. در اصول بنیادین یادگیری تقویتی شامل فرآیندهای تصمیمگیری مارکوف (Markov Decision Processes)، برنامهنویسی پویا (Dynamic Programming) و یادگیری اختلاف زمانی (Temporal Difference Learning) غوطهور شوید. به بررسی عمیق طیف وسیعی از روشهای ارزش و گرادیان خطمشی (Policy Gradient Methods) بپردازید. راهکارهای پیشرفته یادگیری تقویتی مانند فرا-یادگیری (Meta Learning)، یادگیری سلسلهمراتبی (Hierarchical Learning)، یادگیری چند عاملی (Multi-Agent) و یادگیری تقلیدی (Imitation Learning) را به کار ببرید. الگوریتمهای پیشرفته یادگیری تقویتی عمیق (Deep RL) شامل رینبو (Rainbow)، پیپیاو (PPO)، تیدیتری (TD3)، ساک (SAC) و موارد دیگر را درک کنید. از طریق وبسایت همراه کتاب، نمونههای کاربردی دریافت کنید.
اشتراکی
نسخه های مختلفی که برای این کتاب تولید شده در پلتفرم CardDev
نسخه های کتاب
به محضی که نسخه جدید کتاب اومد ، منتشرش میکنیم. غصه خوردی؟! 😉
منتشر شده
مدت زمان خوانش
11:49
نوع کتاب
اشتراکی
شرکت کنندگان
0 نفر
تولید کتاب
۱۶ مهر ۱۴۰۵
